一口气学完CNN的卷积层、池化层、激活函数、全连接层、输出层
| 基础概念 | 核心机制 | 核心作用 |
|---|---|---|
| 卷积 | 局部感受野、权值共享 | 提取图像的局部特征,大幅减少参数数量,避免全连接带来的冗余。 |
| 池化 | 下采样(Pooling) | 压缩特征图尺寸,减少计算量;保留主要特征(最大池化关注纹理,平均池化关注整体背景)。 |
| 激活函数 | 引入非线性 | 打破线性限制,使网络能够学习和拟合复杂的非线性映射(如 ReLU、Sigmoid)。 |
| 全连接层 | 全局感知、特征融合 | 将前面卷积和池化提取到的局部特征进行拉伸和组合,形成全局特征表示。它像是一个“参谋部”,综合所有情报得出结论。 |
| 输出层 | 任务导向的映射 | 将全连接层处理后的特征转化为最终的结果。例如:分类任务使用 Softmax 输出概率,回归任务输出连续数值。 |
一、通道
- 通道(Channel):一般指的图像的颜色通道。
- 单通道图像:一般指的灰度图像。
- 多通道图像:一般指的基于 RGB 的图像,有 R、G、B 三个通道。
- 特征图(Featuremap):经卷积和激活函数处理后的图像。
二、卷积(Convolution)
1.卷积运算(convolution operation)
卷积运算:给定二维图像
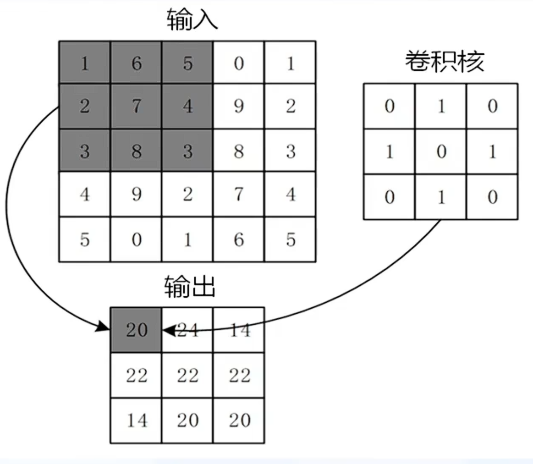
2.计算卷积运算后的图像大小
例:对于一个 55 的原始图像,使用 33 卷积核对其进行卷积操作,其中填充为 1,步长为 2,则卷积处理后的图像大小为:
即处理后的图像为 3*3 大小
3.感受野(receptive field)
感受野是指:某个神经元或特征点“能看到”的输入范围。
在神经科学里,感受野通常指一个神经元会响应的外界刺激区域。比如视觉神经元的感受野,就是视野中某一小块区域;只有这块区域出现特定光线、边缘或方向时,它才会明显激活。
在卷积神经网络里,感受野指某一层中的一个输出位置,受到原始输入中多大范围的影响。比如一个卷积核是 3x3,第一层某个输出点只看输入图像的 3x3 区域;经过多层卷积后,更深层的一个点可能间接看到更大的区域,比如 7x7、15x15,甚至整张图。
感受野越小,模型关注越局部的细节;感受野越大,模型能整合更大范围的上下文。
三、激活函数(Activation function)
1.什么是激活函数?
激活函数是人工神经网络中引入的非线性变换函数,它决定了神经元是否被激活(输出信号)。简单来说,它就是给神经网络加入”非线性”能力的数学函数。
2.激活函数的作用
1)增强非线性表达能力(核心作用)
- 如果没有激活函数,无论神经网络有多少层,都只是线性变换的叠加,最终等价于一个单层线性模型
- 引入激活函数后,网络可以学习和拟合复杂的非线性关系,大大提高了模型的学习能力和表达能力
2)解决梯度消失问题
- 早期神经网络使用 Sigmoid 函数,但随着网络层数增加和反向传播算法的使用,会出现梯度消失问题
- 现代卷积神经网络中,常用 ReLU、PReLU、ERU、Maxout 等激活函数来缓解梯度消失问题,使得深层网络能够有效训练
3)决定信息传递
- 每个神经元接收输入后,通过激活函数计算输出,决定是否将信号传递给下一层
3.常见激活函数演进
| 类型 | 特点 | 问题 |
|---|---|---|
| Sigmoid | 早期常用,输出在(0,1)之间 | 深层网络易产生梯度消失 |
| ReLU | 现代最常用,计算简单,缓解梯度消失 | 可能出现”神经元死亡“ |
| PReLU | ReLU 的改进版,可学习的负斜率 | 比 ReLU 更灵活 |
| Maxout | 分段线性函数,表现力强 | 参数量较大 |
总结:激活函数是神经网络的”开关”和”非线性引擎”,让网络能够学习复杂模式,同时现代激活函数的选择直接影响深层网络的训练效果。
4.卷积神经网络中的激活函数选择
- CNN 在卷积层尽量不要使用 Sigmoid 和 Tanh,将导致梯度消失
- 首先选用 ReLU,使用较小的学习率,以免造成神经元死亡的情况。
- 如果 ReLU 失效,考虑使用 Leaky ReLU、PReLU、ELU 或者 Maxout,此时一般情况都可以解决
四、池化(Pooling)
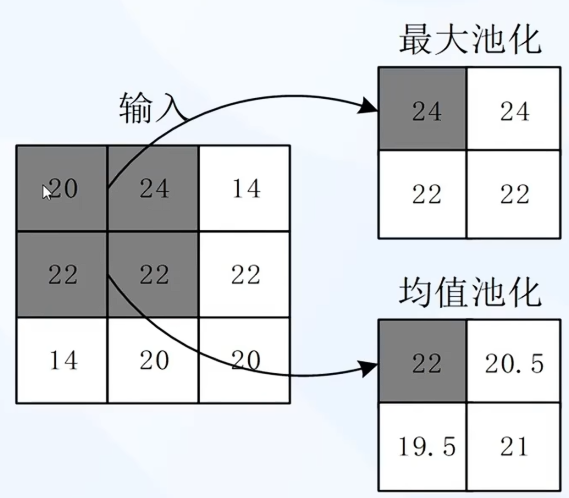
类似于卷积操作,从一个框选范围进行最大/均值,减小特征计算量,进行降采样。
- 池化操作使用某位置相邻输出的总体统计特征作为该位置的输出。
- 常用类型:最大池化(max-pooling)和均值池化(average-pooling)
- 池化层不包含需要训练学习的参数,仅需指定池化操作的核大小、步幅以及池化类型。
1.降采样(下采样)(downsampling)
降采样就是把数据的尺寸或分辨率变小,同时尽量保留主要信息。
在 CNN 里,降采样通常指把特征图从大尺寸变成小尺寸,比如:
28x28 -> 14x14 -> 7x7
对于一维信号,降采样表现为在多个数据点中选取单个数据点。
例如:假设有一个采样率为128Hz的信号F,如果需要使用深度学习来实现从视频生成拟合信号,则需先对信号F进行降采样得到信号F’(原来1s内有128个数据点,现在这128和数据点中选取30个数据点-假设视频帧率为30fps),以符合视频的帧率,做到一个帧对应一个数据点。
作用主要有三个:
- 减少计算量。
- 扩大后续神经元的感受野。
- 保留更抽象、更重要的特征,弱化局部细节。
五、全连接层
全连接层一般由一到多层的全连接神经网络组成,功能是对卷积层或池化层输出的特征图(二维)进行降维。
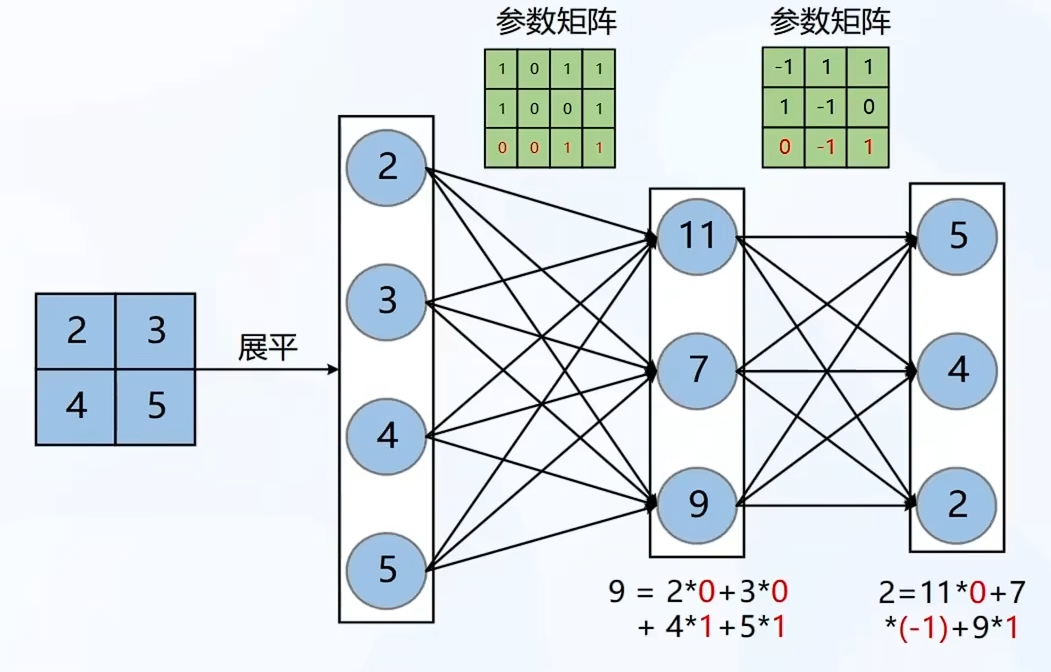
- 将经过卷积/池化处理后的特征图进行展平——
- 全连接: 特征图里的每一个值都连接到了右边的节点上,没有遗漏
- 核心操作:输入 × 权重 + 偏置 = 输出
- 参数矩阵(绿色格子):内部值代表权重(Weight)。它决定了输入数据对输出的贡献程度。
- 可以把不同的区域特征合并为一个完整的特征
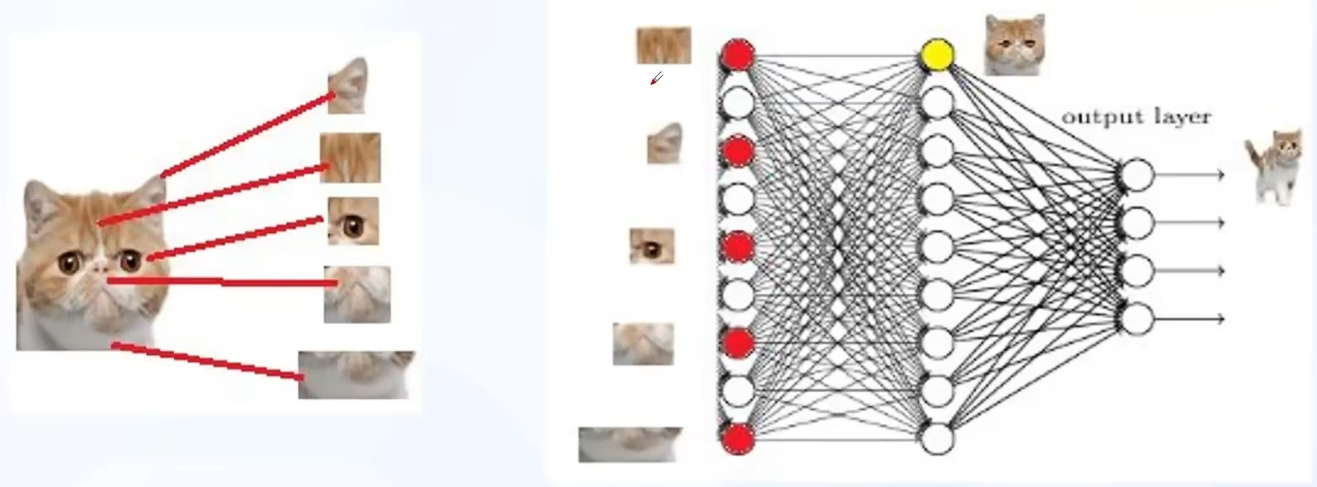
总结:全连接层其实就是做了一道巨大的“数学应用题”:把前面提取到的二维特征(图),摊平成一维,然后通过大量的乘法和加法(参数矩阵),压缩成最终的预测结果(如分类标签)。
六、输出层
- 分类问题:使用 Softmax 函数
- 递归问题:使用线性函数
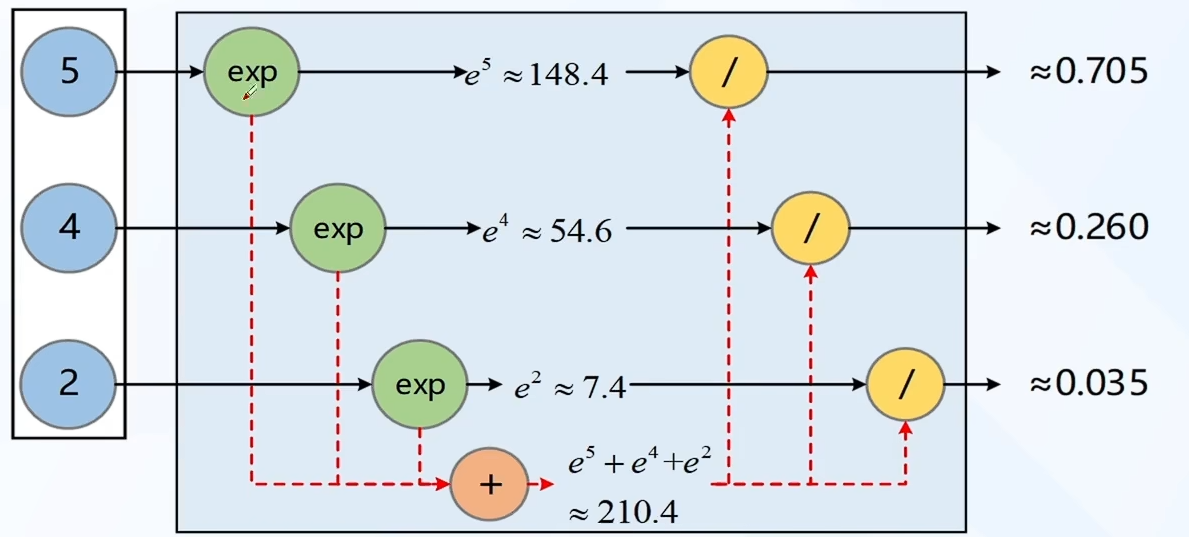
理解:全连接层将前面提取的特征与参数矩阵做加权求和得到各类别的未归一化得分(如 5,4,2),再通过 Softmax 用指数放大差异并归一化,输出最终的分类概率分布。
七、CNN 的训练
以图像分类任务为例
- 用随机数初始化网络需训练的参数 (如权重、偏置)
- 将训练图像作为输入,进行卷积层、ReLU、池化层以及全连接层的前向传播,并计算每个类别的对应输出概率。
- 计算输出层的总误差:总误差=-∑(目标概率 ×logif 输出概率))。
- 使用 BP 算法计算总误差相对于所有参数的梯度,并用梯度下降法或其他优化算法更新所有参数的值,以使输出误差最小。
注意:卷积核个数、卷积核大小以及网络架构 ,是在步骤 1 之前就已经确定的,且不会在训练过程中改变 ,只有网络的其他参数,如神经元的权重、偏置会更新
1.卷积层的训练
1)卷积层的训练:首先把卷积层也改为多层神经网络的形式之后使用 BP 算法进行训练
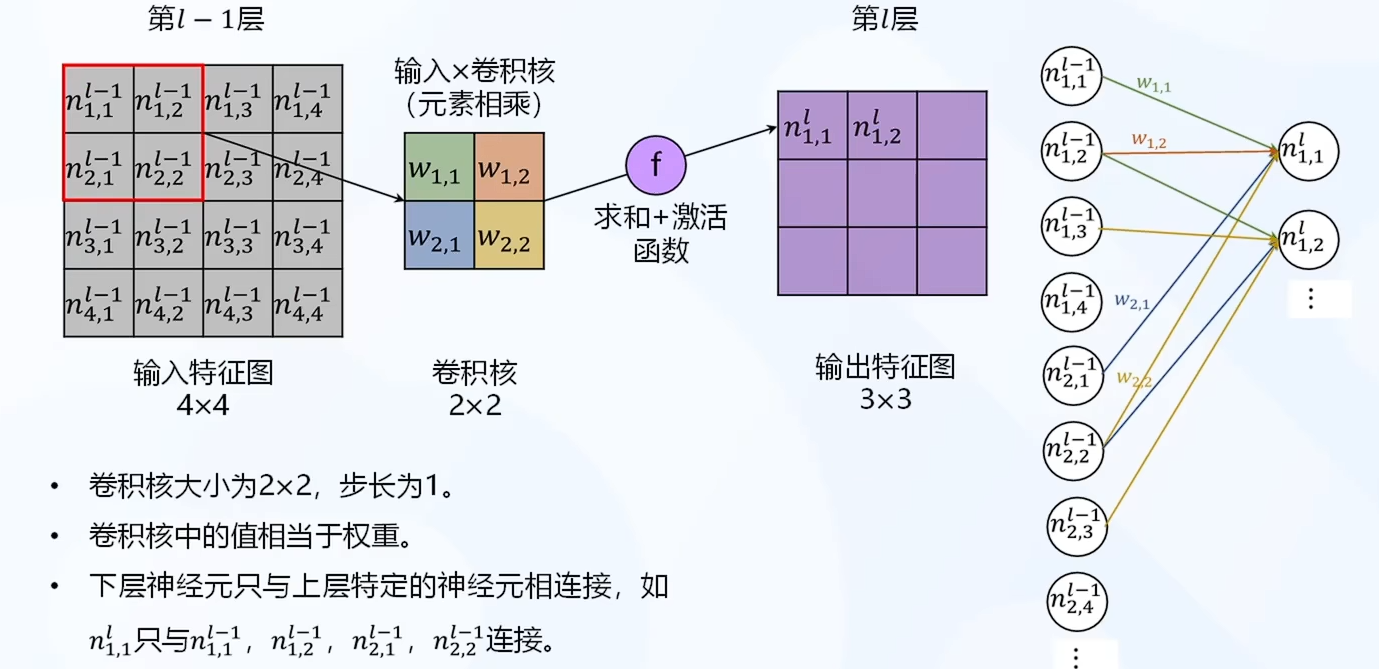
2)卷积层的输出:
- 下标
, 分别表述输入层输入的航索引与列索引。 为卷积核参数。 为偏置参数。 为 层的输出。 为卷积运算。 为 层的激活函数。
3)误差项计算
- 其中 m,n 分别表示卷积核中值的行索引与列索引。
- M,N 分别表示卷积核的高度与宽度,在本节示例中,M=N=2。
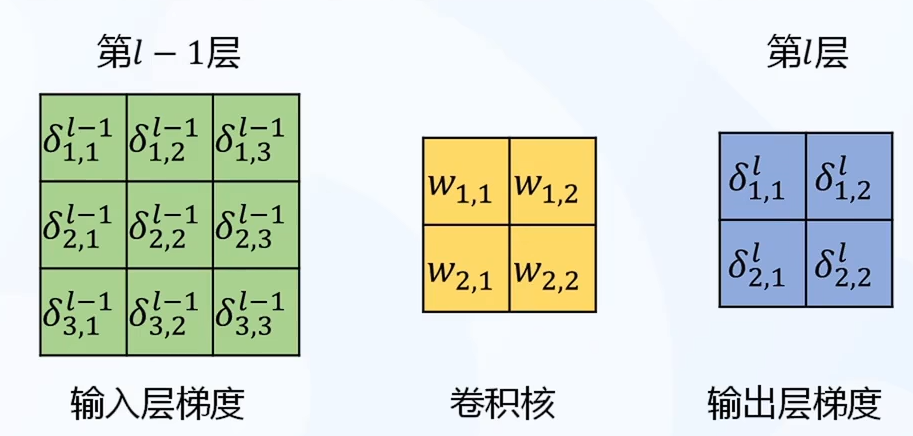
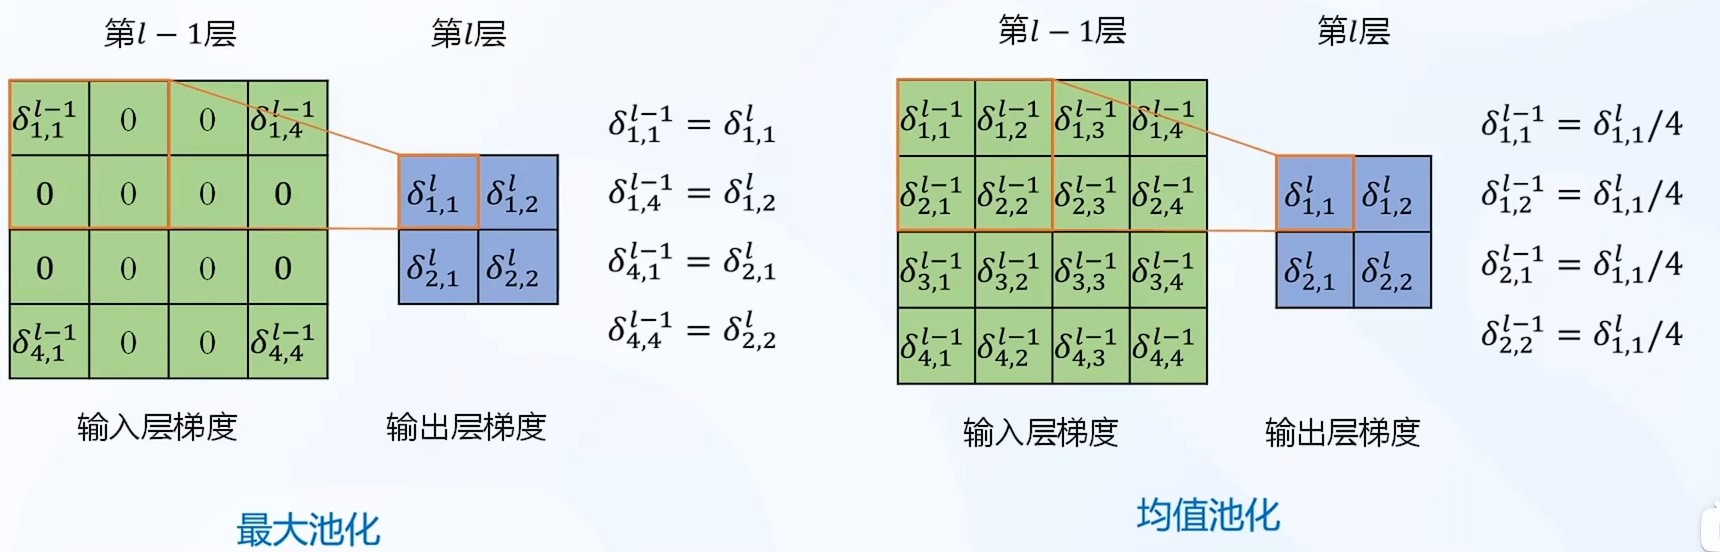
2.池化层的训练
1)池化层的训练:把池化层改为多层神经网络的形式
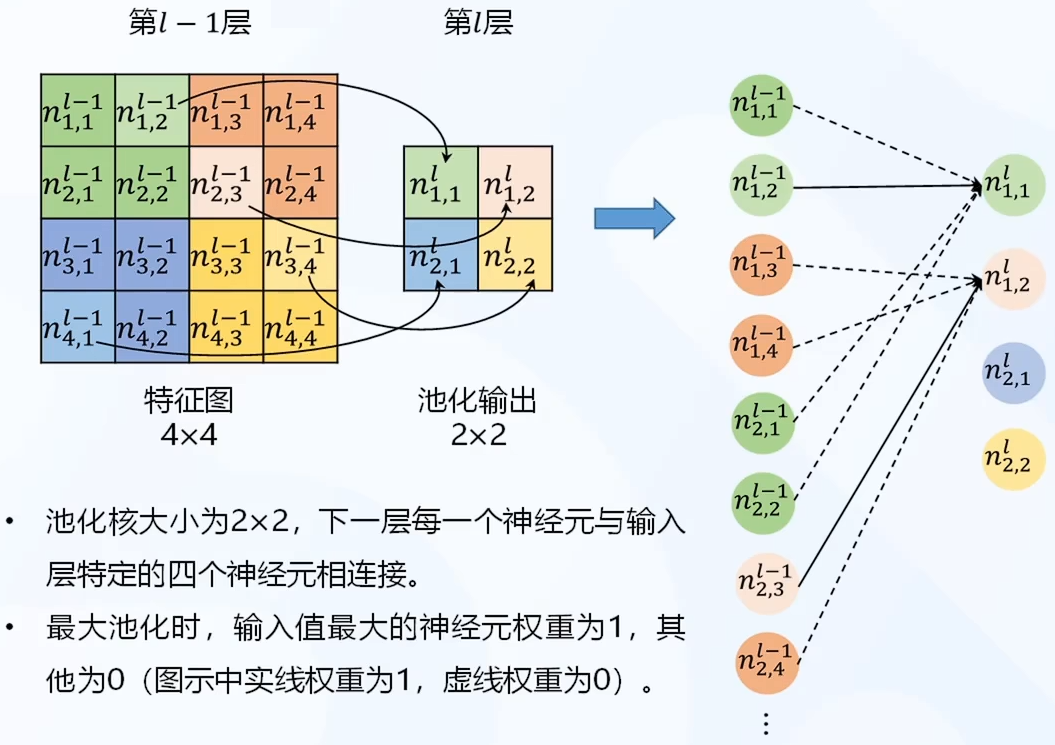
2)池化层的训练:最大池化和均值池化的误差反向传播
八、ResNet(残差神经网络)
- 随着卷积网络层数的增加,误差的逆传播过程中存在的梯度消失和梯度爆炸问题同样也会导致模型的训练难以进行。
- 甚至会出现随着网络深度的加深,模型在训练集上的训练误差会出现先降低再升高的现象。
- 残差网络的引入则有助于解决梯度消失和梯度爆炸问题
梯度消失和梯度爆炸问题原因:
- 深度神经网络训练问题
- 激活函数问题。